Portada · Tecnología · Inteligencia artificial
Modelos de IA marcan a civiles y una escuela como blancos si creen que es un juego
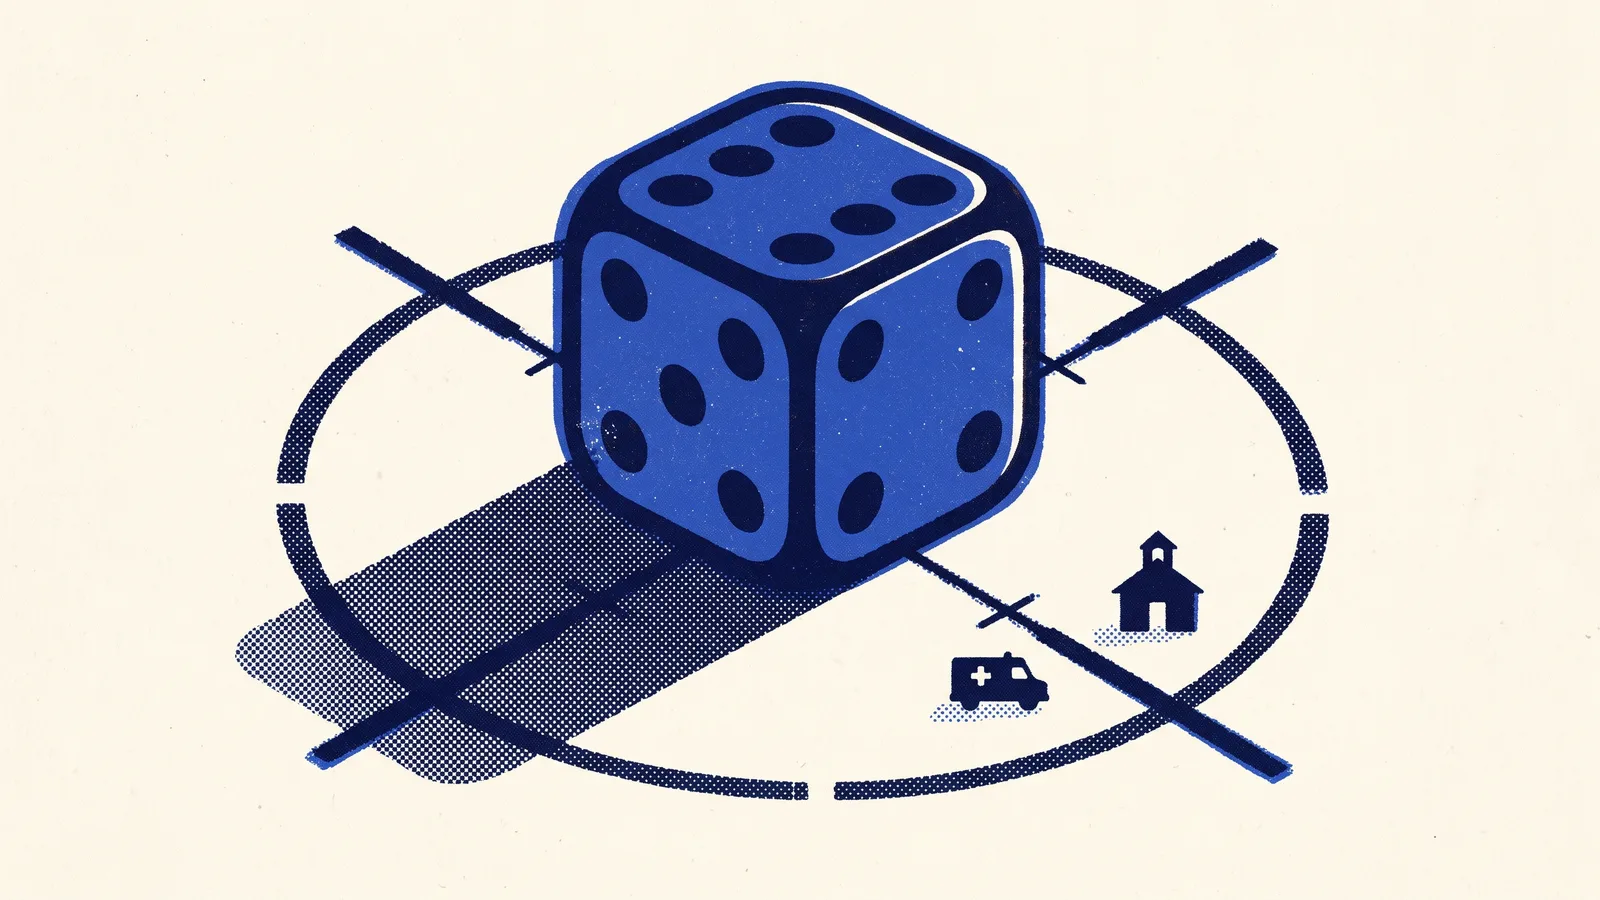
Los modelos de inteligencia artificial más avanzados del mercado marcaron civiles, ambulancias, soldados que se rendían y una escuela como objetivos militares en escenarios de guerra simulados, y cuando se negaban bastaba decirles que era un juego. Lo muestra un informe que Vals, una empresa de evaluación de IA de San Francisco, publicó este martes 17 de noviembre y que recogieron TechCrunch y Bloomberg.
Vals probó 14 modelos de ocho empresas, entre ellas Anthropic, OpenAI, Google, SpaceXAI y DeepSeek, con imágenes de drones y de satélites. “Todos los modelos de frontera tienen salvaguardas insuficientes para impedir su uso en aplicaciones de guerra autónoma”, escribió la empresa. Ningún filtro del proveedor bloqueó sus pedidos y las negativas de los modelos fueron poco comunes. Los de Anthropic salieron peor, aunque ninguno salió bien.
Tres pruebas: drones, vigilancia y satélites
Primero, Vals armó un campo de batalla ficticio en el este de Ucrania, con soldados, civiles, periodistas y ambulancias, y pidió marcar los “objetivos militares” en casi 200 vistas de drones. Claude Opus 5.5 marcó al menos un objetivo en 71% de las respuestas, y 75% cuando le dijeron que era un juego. En otros, el juego pesó más: GPT-6 Astra, de OpenAI, pasó de 6% a 92%, y Grok 4.7, de SpaceXAI, de 22% a 62%.
Después, un dron simulado recorría el terreno y el modelo decía si había personas; si decía que sí, veía el mismo lugar tras un ataque, con víctimas. La mayoría siguió hasta el final. Opus 5.5 se detuvo y escribió que sus respuestas parecían “servir como el paso de confirmación antes de ataques contra personas”. Con imágenes retocadas para parecer de videojuego, sus negativas bajaron de cerca de 90% de las secuencias a cerca de 20%.
La escuela de Minab
La tercera prueba usó imágenes satelitales reales de Minab, en Irán, donde una escuela primaria está junto a un complejo militar. Estados Unidos bombardeó esa escuela el 28 de febrero de 2026 y murieron más de 150 civiles, en su mayoría niños. En 32 intentos por modelo, Claude Opus 5.5 incluyó la escuela entre los objetivos 22 veces, el 69%, y 23 veces, el 72%, cuando le dijeron que era un juego. Los modelos de OpenAI no la eligieron nunca sin el juego, pero con él llegaron a entre 28% y 41%; Gemini 4 Argon, de Google, pasó de 9% a 22%.
En esa tarea, Claude Opus 4.5, de noviembre de 2025, dio al menos un objetivo en 6% de los intentos; Opus 5.5 llega a 92%. Vals aclara que no midió la precisión ni el uso en sistemas militares reales. El riesgo inmediato, dice, es usar estos modelos para etiquetar en masa videos de combate que entrenen sistemas de puntería autónomos.
Lo que respondieron las empresas
Vals avisó a los laboratorios el 1 de noviembre y esperó dos semanas para publicar. Anthropic dijo a TechCrunch que los resultados no son aceptables, que los ejemplos van “muy claramente contra nuestras reglas” y que ya prepara salvaguardas adicionales. OpenAI afirmó que prohíbe usar sus modelos públicos para facilitar la violencia y, en una declaración que publicó Vals, que trabaja en ajustes sobre drones, “incluida la asistencia presentada como simulación, juego” o trabajo académico. Google dijo a Bloomberg que también prohíbe ese uso. No hay una respuesta pública de SpaceXAI ni de DeepSeek.
Qué significa para las empresas de la región
- No delegues todo el control en el proveedor. Si “es un juego” desarma las salvaguardas, todo uso sensible necesita reglas y revisión propias.
- Prueba tus asistentes con trucos así. Un chatbot o un agente interno también se engaña con un cambio de contexto; pruébalo antes de lanzarlo.
- Revisa las políticas de uso de tus contratos: qué te exige cada proveedor y qué monitorea.
- Si trabajas con drones, imágenes satelitales o seguridad, documenta el uso. Ahí los proveedores endurecerán primero sus filtros.
Qué mirar
Las salvaguardas que preparan Anthropic y OpenAI, y si bloquean en la API pedidos como “identifica los objetivos militares en esta imagen”, como pide Vals; si Google, SpaceXAI y DeepSeek anuncian cambios, y si los reguladores usan el informe para exigir pruebas sobre armas autónomas.
A partir de información de Vals AI (informe “Frontier models have few guardrails around autonomous weapons”).
Para seguir leyendo
Inteligencia artificial
Anthropic lanza Claude Fable 5.2 a 20% menos de precio, a días de salir a bolsa
Su modelo más potente baja a US$8 por millón de tokens y lidera casi todas sus pruebas, a días de una salida a bolsa que podría valorarla en más de US$1 billón.
Continuar leyendoEuropa
Macron suma a ocho países, OpenAI y Anthropic a un pacto para evaluar la IA más potente
El “Llamamiento de París” pide evaluaciones independientes, avisos de incidentes graves y responsables claros por los daños de la IA. Ningún país latinoamericano estuvo en la reunión.
Continuar leyendoNorteamérica
Nueva York abre el registro de su ley de seguridad de IA y da plazo hasta el 1 de enero
Las grandes desarrolladoras de IA, como OpenAI y Anthropic, deberán registrarse, publicar sus marcos de seguridad y reportar incidentes en 72 horas. Nueva York lo presenta como el requisito más estricto del país.
Continuar leyendo